摩根士丹利:大摩 半导体:AI生态系统如何绕开内存瓶颈?
摘要公开阅读;PDF 仅限有效会员阅读与下载,所有会员权限相同。 邮件登录
摘要
摩根士丹利认为内存短缺将贯穿本轮 AI 周期,AI 基本会用尽可见未来的全部供给,而行业不会等 DRAM 新厂建成,必须找到绕开瓶颈的办法,报告正是由 NVIDIA CEO Jensen Huang 相关言论触发。 报告梳理三条路径:一是去规格化,削减机架级 LPDDR5 并选择性降低 HBM 堆叠(Rubin de-spec 从 12hi 降到 8hi),瓶颈部分从 DRAM 转向 NAND,并边际推动更大 scale-up 域;二是拆分推理,把计算受限的 prefill 与内存带宽受限的 decode 分开独立扩展,Cerebras、NVIDIA Groq、d Matrix、SambaNova 提供不同片上 SRAM 路线;三是 CXL 内存扩展/共享/池化,把 CXL 硅机会从超 $4bn 的内存控制器市场扩展到 2030 年约 $6bn。 需求侧支撑在于前沿模型规模每 6 个月翻倍、上下文窗口每年约 5 倍增长(闭源约 4.8x/yr、开源约 6.1x/yr)、主流模型上下文已达约 1M tokens,因此降规格只是暂时。 验证点上,Cerebras 与 AMD 的组合方案预计 4Q26 投产、与 AWS 的方案预计 1Q27 进入 Amazon Bedrock,组合吞吐最高提升 5 倍;Marvell 预计 CXL 在 CY2028 附近贡献超 $1bn 收入,Astera 的定制 KV-cache offload 设计订单 2027 年放量。 大摩强调降规格源于供给约束而非价格,未来重新升规格时新增供给极易被吸收,内存周期的核心风险与计算板块一致即 AI 本身减速,并特别提示土地/电力/厂房瓶颈型暂停对内存的额外扰动。 行业观点维持 Attractive,因看不到短缺结束而继续超配 MU 与 SNDK,潜在受益方还包括 MRVL、ALAB(CXL 与更大 scale-up)和 CBRS(拆分推理)。
主要观点
- 核心判断:内存短缺预计贯穿本轮 AI 周期,AI 基本会用尽可见未来的全部供给,行业不会等 DRAM 工厂建成。
- 报告催化剂是 NVIDIA CEO Jensen Huang 等计算公司提出需要换思路绕开内存瓶颈,且这是一场正面对话——业界明确预期短缺将持续多年。
- 路径一去规格化:削减机架级中央内存 LPDDR5、选择性降低 HBM(如 Rubin 从 12hi 降到 8hi),是很多方面最不利但有时必需的做法;瓶颈部分从 DRAM 转向 NAND,边际上推动更大 scale-up 域,利好 ALAB 和 MRVL。
- 降规格只是暂时:前沿模型规模每 6 个月翻倍(LLM 时代趋势年化 4.0x),上下文窗口每年约 5 倍增长(闭源约 4.8x/yr、开源约 6.1x/yr),主流模型上下文已达约 1M tokens,三大向量持续推高各级内存需求。
- 降规格沿内存层级下移创造新机会:NVIDIA 去规格 LPDDR5 机架已带来 KV cache 存储对 NAND 的增量需求;存储在 HBM 的数据需分散到更多 GPU 或从主内存读取,加大 scale-up 带宽与 CPU IO 压力。
- NVIDIA 定制 HBM4e 较 JDEC 标准带宽高 30%、PHY 与支撑面积缩小 67%;但定制 base die 引入后,HBM 带宽驱动(DRAM PHY)可由计算厂商设计,价值可能转移离开 DRAM 厂商。
- Rubin Ultra 及之后的关键变量是 scale-up 域:NVIDIA 已表示改变 Kyber 形态并提高 scale-up 域(每机架更多 GPU),可使机架级总内存容量保持不变而单 GPU 内存更少。
- 路径二拆分推理:prefill 通常受计算限制、decode 通常受内存限制,两阶段分开独立扩展对代码助手、agentic 应用与长上下文负载尤其有效;行业走向异构推理,SRAM 阵营包括 Cerebras 晶圆级方案、NVIDIA Groq LPU(整合进 Vera Rubin 平台)、d Matrix 内存内计算、SambaNova 三层内存架构。
- Cerebras 是拆分推理最清晰的纯受益标的:与 AMD 合作的方案(Helios 负责 prompt 处理、Wafer Scale Engine 负责 decode)预计 4Q26 投产,与 AWS Trainium 的组合预计 1Q27 进入 Amazon Bedrock;双方已披露组合系统吞吐最高提升 5 倍,直接改善 Cerebras Cloud 经济性。
- 路径三 CXL:扩展、共享、池化三大用例让内存不再绑定单一 CPU/服务器;AI 把 CXL 机会从超 $4bn 的内存控制器市场扩展至 2030 年约 $6bn,Marvell 将 CXL 定位为 XPU-attach 业务中 CY2028 附近超 $1bn 的收入贡献,Astera 的定制 KV-cache offload 设计订单 2027 年放量。
- 对 DRAM 并非利空:因供给约束(而非价格)降规格,未来重新升规格时新增供给极易被吸收;内存周期风险与计算板块一致即 AI 本身减速,特别风险是若 AI 因土地/电力/厂房瓶颈而非需求放缓,会造成计算板块看不到的内存扰动。
- 评级结论:北美半导体行业观点维持 Attractive;因看不到短缺结束,继续超配 MU 和 SNDK;报告点名的潜在受益方还包括 MRVL、ALAB(CXL 与更大 scale-up)与 CBRS(拆分推理)。
论述逻辑
- AI token 增长快于内存供给 → 短缺贯穿周期且 AI 不会等待建厂 → Jensen Huang 等呼吁绕开瓶颈 → 三条提效路径:去规格化(降 LPDDR5/HBM 堆叠,把瓶颈移向 NAND、网络与更大 scale-up 域,利好 ALAB/MRVL)→ 拆分推理(prefill 与 decode 分离,SRAM 架构的 CBRS/Groq/d Matrix/SambaNova 承接 decode,NVDA 借 Groq 参与)→ CXL 扩展/共享/池化(内存集中复用,TAM 由 >$4bn 走向 2030 年约 $6bn)→ 但模型每 6 个月翻倍、上下文窗口每年约 5 倍增长决定了降规格只是暂时,重新升规格时新增供给极易被吸收 → 内存周期的主要风险与计算板块同为 AI 减速,唯一例外是土地/电力/厂房瓶颈型暂停会给内存带来计算板块没有的扰动 → 结论:行业观点 Attractive,维持 MU、SNDK 超配,点名 ALAB、MRVL、CBRS、NVDA 为潜在受益方。
关键展望
- 内存短缺预计贯穿本轮 AI 周期,AI 基本会用尽可见未来的全部供给;团队目前对内存状况做大量月度核查,工作假设是内存周期的风险等同于计算板块的风险。
- HBM 关键观察点:随着 HBM 代际演进,厂商能否为更高带宽收取溢价(历史上一直如此);定制 base die 使 DRAM PHY 可由计算厂商设计,可能使价值转移离开 DRAM 厂商。
- Rubin Ultra 具体形态未知,但 NVIDIA 已表示改变 Kyber 形态、提高 scale-up 域(每机架更多 GPU),使机架级总内存不变而单 GPU 内存更少。
- CXL 机会到 2030 年约 $6bn;Marvell 预计 CXL 在 CY2028 附近为 XPU-attach 业务贡献超 $1bn 收入(为其 2028 年预估的重要部分);Astera 的 Leo X 面向加速器侧内存需求,定制 KV-cache offload 设计订单 2027 年放量。
- Cerebras 与 AMD 的组合方案预计 4Q26 投产,与 AWS Trainium 的组合预计 1Q27 进入 Amazon Bedrock;Cerebras 与 AMD 已披露组合系统吞吐最高提升 5 倍。
- 风险提示:若 AI 因土地/电力/厂房瓶颈(而非需求)减速,这类暂停可能造成计算板块不会出现的内存扰动。
推荐标的
- Micron Technology(MU.O):超配(O,评级日期 2025/10/06),股价 $1,074.89(2026/10/02);报告核心动作即维持 MU 超配,理由是看不到内存短缺结束。
- SanDisk(SNDK.O):超配(O,评级日期 2025/03/03),股价 $1,719.99(2026/10/02);与 MU 并列为本轮内存短缺持续下的核心超配标的。
- Astera Labs(ALAB.O):超配(O,评级日期 2025/05/11),股价 $350.33(2026/10/02);报告列为 CXL 与更大 scale-up 域的潜在受益方,其 Leo X 面向加速器侧内存需求,KV-cache offload 设计订单 2027 年放量。
- Marvell(MRVL.O):中性(E,评级日期 2015/09/14),股价 $272.29(2026/10/02);报告列为 CXL 与更大 scale-up 域潜在受益方,Structera X 面向内存控制器、Structera S 面向机架级共享/池化交换,公司预计 CXL 在 CY2028 附近贡献超 $1bn 收入。
- Cerebras Systems(CBRS.O):超配(O,评级日期 2026/06/08),股价 $166.43(2026/10/02);拆分推理最清晰的纯受益标的,与 AMD 方案预计 4Q26 投产、与 AWS 方案预计 1Q27 进入 Amazon Bedrock,组合吞吐最高提升 5 倍。
- NVIDIA(NVDA.O):超配(O,评级日期 2023/03/16),股价 $233.95(2026/10/02);通过将 Groq 技术整合进 Vera Rubin 平台参与拆分推理,Rubin GPU 负责 prefill 与 decode 的注意力部分,Groq 负责前馈与 MoE 部分。
- 行业观点:北美半导体行业评级维持 Attractive(未来 12-18 个月行业覆盖组合表现被预期优于相关大盘基准)。
关键图表
图1. 前沿AI模型规模每6个月翻一番
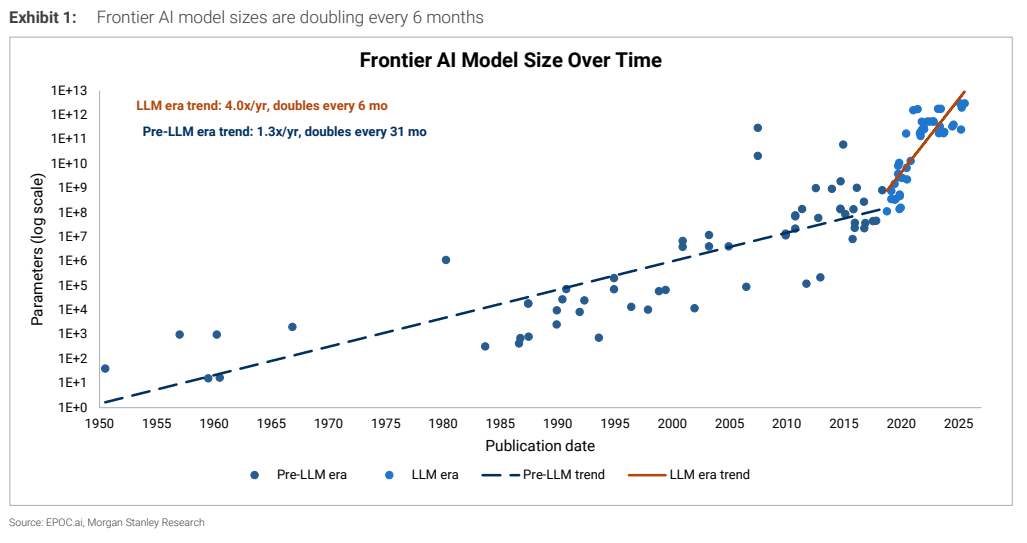
图2. LLM上下文窗口每年增长约5倍
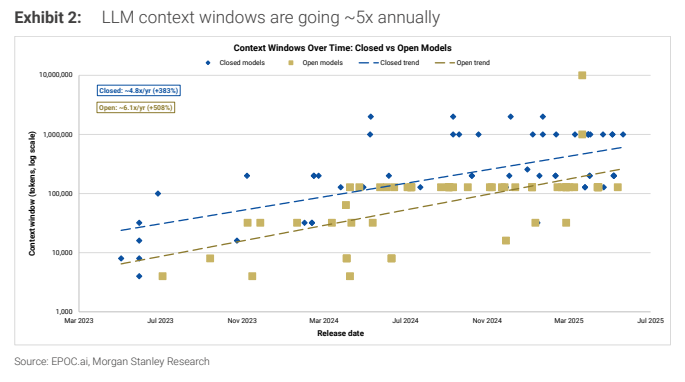
图3. 降规格HBM/LPDDR应会开辟更低端的机会

图4. 英伟达定制HBM4e带宽较JDEC标准高出30%
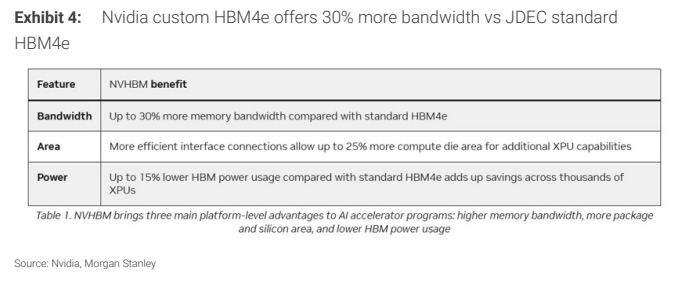
图5. 英伟达定制HBM的PHY及支撑面积较JDEC标准减少67%

图6. AI推理分为两个不同阶段:预填充(prefill)与解码(decode)
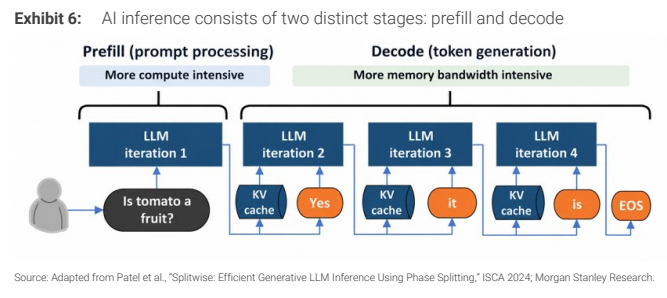
图7. AI基础设施总支出预测

图8. 内存扩展:增加额外内存

图10. 内存池化:创建共享内存池

图11. 峰值硬件FLOPS及内存/互连带宽的扩展

图12. XL TAM,2026-2030年(百万)
